Feb 11 2009

HelpSemaforoQuesto semaforo indica il livello difficoltà del post
semaforo verde - articolo per tutti semaforo giallo - articolo avanzato semaforo rosso - articolo per esperti

Ancora sul tempo sul sito

autore: Marco Cilia categoria: web analytics

orologiOltre al commento di Antonio, è un periodo che mi capita di leggere in giro domande sul tempo sul sito. Penso sia necessario ritornarci ancora una volta, perché è un concetto mai abbastanza ribadito, ed è importante comprenderlo fino in fondo:

Nel nostro mondo il tempo è un concetto lineare, lo impariamo sin da piccoli. Non è invertibile, scorre in un solo senso, ed ha intervalli di durata nota: un secondo, un minuto, tre ore, cinque giorni… Possiamo quasi sempre sapere quanto tempo occorra affinché una cosa accada, sia che debba ancora accadere sia che stia accadendo. Ad esempio quando rispondiamo alla domanda “tra quanto tempo tramonterà il Sole?” facciamo la differenza tra l’ora del tramonto e l’ora corrente. Quando invece proviamo a capire se nostro figlio sarà un campione di apnea iniziamo a contare quando immerge la testa sott’acqua e smettiamo quando risale paonazzo 🙂
Questi due esempi hanno qualcosa in comune: si basano sulla differenza tra due momenti distinti.

Nel mondo dei bit, e di internet in particolare, le cose sono leggermente più complicate: l’HTTP, cioè il protocollo attraverso il quale viaggiano le informazioni sul web, è un protocollo senza comunicazione di stato (stateless), e questo comporta il fatto che ogni richiesta che viene fatta “riparte da capo”, non ha memoria di ciò che è successo prima. Inoltre le richieste vengono in genere fatte dal browser e le risposte vengono date dal server, che chiude la comunicazione appena ha terminato il compito e aspetta la prossima richiesta, dello stesso o di un altro browser. In una ipotetica conversazione umana, le cose andrebbero all’incirca così:

browser1: “ciao server, sono Firefox dall’ip 1.2.3.4 e mi serve la pagina index.html”
server: “eccoti la pagina index.html”
browser2: “ciao server, sono Internet Explorer dall’ip 6.72.33.124 e mi serve la pagina index.html”
server: “eccoti la pagina index.html”
browser1: “ciao server, sono Firefox dall’ip 1.2.3.4 e mi serve la pagina contatti.html”
server: “eccoti la pagina contatti.html”

e così via. Nessuna frase inizia con “ti ricordi di me? ora mi servirebbe…”

Questo preambolo serve ad introdurre la frase centrale di questo post: che si usi un sistema basato su logfiles o su tag javascript, di ogni comunicazione viene registrata SOLO E SOLTANTO la data e l’ora di richiesta.

Da qui l’assunto numero due: per calcolare il tempo di stazionamento di un utente su una pagina, servono gli stessi dati che usiamo noi per calcolare la dimensione di un lasso temporale: servono almeno due orari. D’altronde i computer sono costruiti dagli uomini, e sanno solo fare meglio i calcoli 🙂

Se una persona non guarda due pagine, non sarà possibile sapere per quanto tempo è stata sull’unica che ha visto (ed ecco perché i bounce contano zero).
Se una persona guarda 6000 pagine, il calcolo sarà fatto su 5999, perché non è nota l’ora in cui è stata vista la pagina 6001, che non esiste.
Sarebbe come se – ipoteticamente – nel mondo reale un osservatore dovesse calcolare quanto tempo un uomo rimane dentro una stanza: ci rimane il tempo che intercorre tra l’ora in cui esce e l’ora in cui entra. Ma se questo uomo fosse in grado di teletrasportarsi altrove dopo essere entrato?
Analogamente al famoso gatto di Schrödinger un utente su una pagina può essere considerato sia come “visita ancora attiva” sia come “visita terminata”. L’equivalente dell’aprire la scatola per noi è la visita della pagina successiva.

Questo problema viene risolto dalla web analytics introducendo il concetto di “tempo della sessione”, ovvero un tempo solitamente configurabile – e per convenzione impostato a trenta minuti – entro il quale se non viene registrato un’altra data/pagina vista la visita viene considerata conclusa (in Google Analytics si usa la funzione _setSessionTimeout). Per continuare con l’analogia della stanza, è come se l’osservatore esterno di cui sopra avesse istruzioni di andarsene e non registrare nulla se la persona non esce dalla stanza dopo mezz’ora.

In conclusione ricordatevi una cosa: di ogni pagina si conosce esclusivamente il momento in cui l’utente inizia a guardarla… almeno fino a quando non ne guarda un’altra 🙂

image credits: Fabiola Medeiros su Flickr


Feb 08 2009

HelpSemaforoQuesto semaforo indica il livello difficoltà del post
semaforo verde - articolo per tutti semaforo giallo - articolo avanzato semaforo rosso - articolo per esperti

Bug nella selezione delle dimensioni

autore: Marco Cilia categoria: report

Oggi vi segnalo un “baco” in Google Analytics che si presenta guardando il report “contenuti principali”: le pagine visualizzate di un dato contenuto nel riepilogo non coincidono con quelle del dettaglio quando si seleziona una dimensione dal relativo menu a tendina. Per capirci con una immagine (clicca per ingrandirla):

bug-content-report

selezionando la dimensione keyword (o città, o altro) le pagine visualizzate passano da 1625 a 2170.

In realtà non è propriamente un baco, ma uno strano comportamento deliberatamente progettato. Il concetto alla base di tutto è che i contenuti vengono elencati per pagine viste, ma le dimensioni sono basate sulle visite. Se il totale delle pagine viste in un dato giorno è 100, sarà 100 anche il totale mostrato nel report “contenuti principali”. Ora, assumiamo che solo un visitatore da Roma guardi la pagina “scarperosse.htm”, ma che guardi anche altre tre pagine. Il report dei contenuti riporterà correttamente 1 pageview per la pagina scarperosse.htm, e così anche selezionando il dettaglio dei dati disponibili per quella pagina. Passando però al segmento Città tramite il menu a tendina “dimensione”, le pagine viste passano a 4 perché il totale delle pagine viste da Roma è quello.

La buona notizia è che anche gli ingegneri di Google concordano che questo comportamento, benché corretto dal punto di vista numerico, è fuorviante dal punto di vista delle analisi. Il 19 dicembre scorso, in questo thread del forum ufficiale, Analyticspro.Anna rispondeva:

Hey Guys,

Thanks for bringing up this issue. We have heard about this issue from many people and are working on this. We will get this fixed as soon as possible.

Thank you all for your patience in the mean time.

Dall’idea che mi sono fatto leggendo il thread, in particolar modo le risposte dell’utente Shoretel (che stimo particolarmente), ho idea che la soluzione non sarà introdotta nel brevissimo periodo…

e un grazie al sempre prolifico Marco Ziero, che mi ha fatto sbattere il naso nel problema con una delle sue solite domande a bruciapelo 🙂


Feb 06 2009

HelpSemaforoQuesto semaforo indica il livello difficoltà del post
semaforo verde - articolo per tutti semaforo giallo - articolo avanzato semaforo rosso - articolo per esperti

SEO report in Google Analytics

autore: Marco Cilia categoria: report

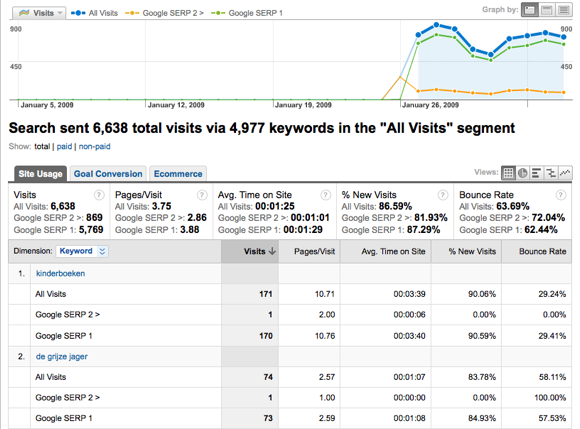
Mi rendo conto che ultimamente fungo quasi solo da segnalatore di post altrui, ma tant’è spero che siano comunque cose che possano interessare. In questo caso sul prolifico YOAST Reinout Wolfert ha scritto un post con un report specificatamente pensato per i SEO, ovvero un report con una comparazione grafica tra le visite totali, quelle provenienti dalla prima pagina di google e tutte le altre.

Niente di trascendentale (gran parte del lavoro è basato sul famoso post di André Scholten, poi migliorato da Damon Gudaitis), ma comunque una risorsa utile. E’ interessante notare che negli screenshot postati il totale delle visite provenienti dalla somma di tutte le pagine dei risultati di Google superiori alla prima è di gran lunga inferiore al totale delle visite provenienti dalla prima pagina. C’è da lavorare molto sulla coda lunga 🙂

seo reports by yoast.com


Feb 03 2009

HelpSemaforoQuesto semaforo indica il livello difficoltà del post
semaforo verde - articolo per tutti semaforo giallo - articolo avanzato semaforo rosso - articolo per esperti

Raggruppare i contenuti

autore: Marco Cilia categoria: filtri

C’è una cosa che Google Analytics non fa nativamente, al contrario di strumenti considerati “più professionali” e costosi: i cosiddetti Content Group, ovvero gruppi più o meno omogenei di pagine o contenuti categorizzati con un nome, la cui analisi può essere fatta in forma aggregata.
In realtà GA consente di analizzare gruppi di URL in forma aggregata tramite il report “dettaglio contenuto“, ma in questo caso i gruppi sono determinati dalla struttura degli URL del sito (directory e sottodirectory, fisiche o create ad arte tramite riscrittura degli URL), oppure si possono analizzare gruppi di pagine che abbiano una parte comune di title tramite il report “contenuti per titolo“.

La soluzione di E-nor è quella di applicare dei filtri avanzati (ad un profilo-copia, aggiungerei) in grado di sostituire ad esempio tutti gli URL che contengono la parola ADIDAS con un url secco tipo /adidas.html

Allargando il discorso si può ipotizzare un tentativo “alla webtrends” in cui il raggruppamento avviene tramite una regular expression (o una regular expression per il nome della pagina + un parametro particolare), sempre tramite filtro avanzato, oppure una via più elegante che modifichi il title della pagina aggiungendo il nome del content group, lasciando intatto l’URL per eventuali altre analisi.
La soluzione proposta è indubbiamente valida, ma non mi fa impazzire per almeno due motivi:

  1. il primo, come ho avuto di dire nei commenti a quel post, è che su siti di grandi dimensioni potrebbero esserci problemi con url che contengono due termini da sostituire, nel qual caso il primo filtro farebbe tutto il lavoro trattenendo la pagina dentro al relativo content-group. Più in generale il sistema proposto è più facile da implementare in siti con URL rewrite attivo, mentre risulta più difficoltoso con url “criptici”
  2. il secondo, più importante, è che questo è un workaround: i content group dovrebbero funzionare come i tag, evitando il problema di cui al punto precedente e permettendo ad una pagina di essere conteggiata in due o più gruppi di contenuto

Come sempre, se sapete esattamente cosa state facendo e quali dati in uscita avrete potete operare; diversamente bisognerà aspettare che Google implementi nativamente questa funzione, oppure suggerirla tramite il form apposito 🙂


Feb 01 2009

HelpSemaforoQuesto semaforo indica il livello difficoltà del post
semaforo verde - articolo per tutti semaforo giallo - articolo avanzato semaforo rosso - articolo per esperti

Tracciare link e download tramite gli eventi

autore: Marco Cilia categoria: javascript

Oggi voglio segnalarvi uno script che alcuni di voi potrebbero trovare utile, e che serve a tracciare i click sui link esterni e sui download tramite gli eventi di Google Analytics, anziché tramite il classico metodo delle “pagine virtuali”. E’ una tecnica descritta da Stephane Hamel sul blog immeria, e ve la posso presentare senza averla provata perché gli autori sono gli stessi dell’estensione WASP, per cui possiamo fidarci!

I click sui link esterni saranno tracciati con un evento di nome “outbound”, una action “click” e una label uguale all’url visitato. I download invece avranno un evento “download”, la stessa action “click” e una label uguale al nome del file scaricato. L’espressione regolare predefinita è questa
/\.(docx*|xlsx*|pptx*|exe|zip|pdf|xpi)$
e cerca sostanzialmente eseguibili, pdf, archivi zip, estensioni di Firefox e documenti Office 2007, ma siete ovviamente liberi di modificarla come più vi pare cercando nel file gaAddons.js la riga
var fileTypes = new RegExp(/\.(docx*|xlsx*|pptx*|exe|zip|pdf|xpi)$/i);
e modificandola in base ai tipi di file che il vostro sito propone agli utenti.

Per abilitare questo tracciamento è sufficiente scaricare il file gaAddons.js dal sito di immeria, caricarlo sul proprio server e aggiungere una riga al codice html delle pagine, prima della chiusura di BODY, non importa se prima o dopo la chiamata al GATC. La riga da aggiungere è
<script src="/js/gaAddons.js" type="text/javascript"></script>

nell’ipotesi in cui il file risieda nella sottocartella /js/, altrimenti dovrete indicare il percorso per trovare il file dello script.

E’ una soluzione che ritengo valida, ma che non implementerò a tappeto sui profili che gestisco, miei o dei clienti. Valuterò caso per caso se il beneficio ottenuto vale lo sforzo (sforzo di installazione, ma anche di manutenzione e di interpretazione dei report). Il criterio sul quale mi baserò è puramente numerico, infatti ritengo che questa implementazione tramite gli eventi porti benefici su siti con grandi numeri, dove il numero di click su link esterni e download è significativo e quindi il numero di pageviews virtuali ha un impatto di un certo tipo sui totali visualizzati da GA. Per siti di piccole dimensioni, al momento, non ritengo necessario l’uso degli eventi per questo tipo di monitoraggio, e resta sempre valido il sistema automatizzato realizzato da me e Francesco Terenzani


Jan 28 2009

HelpSemaforoQuesto semaforo indica il livello difficoltà del post
semaforo verde - articolo per tutti semaforo giallo - articolo avanzato semaforo rosso - articolo per esperti

Il vostro bounce rate salirà, ma niente panico!

autore: Marco Cilia categoria: generale

Bounce by GreencolanderHo letto questa notizia su tre diversi blog, ma ho aspettato a segnalarla finché non è apparsa su una fonte che ritengo autorevole: Google ha modificato il modo in cui conteggia i bounce rate in presenza della funzione _setVar(). [edit: ecco il post sul blog ufficiale | e in italiano]

Fino ad oggi se un visitatore guardava una sola pagina, non veniva conteggiato come bounce se nella stessa pagina chiamavate la funzione _setVar(), che serve ad attribuire il visitatore ad un segmento personalizzato tramite scrittura del cookie aggiuntivo __utmz. Infatti per ovviare a questo problema Lunametrics aveva proposto un workaround che vi segnalai a tempo debito.

Da oggi questo fatto non è più vero, e una visita di una sola pagina vista sarà considerata un bounce a prescindere dalla presenza della funzione. Tra le altre cose questa modifica si rifletterà anche sul tempo medio sul sito e sulla pagina, poiché in presenza di due timestamp GA è in grado di calcolare un tempo, cosa che invece ovviamente non può essere vera per un utente che rimbalza. In precedenza invece Analytics assegnava tempi brevissimi (zero, uno o due secondi, a seconda della velocità di caricamento della pagina e del tempo trascorso tra la chiamata a _trackPageview() e _setVar() ) alla pagina.

Da quel che ho capito, il comportamento non cambia in presenza di un evento, come scrissi in questo post

Image credit: Greencolander on Flickr


Jan 26 2009

HelpSemaforoQuesto semaforo indica il livello difficoltà del post
semaforo verde - articolo per tutti semaforo giallo - articolo avanzato semaforo rosso - articolo per esperti

Ci sarà l’integrazione Analytics-Feedburner?

autore: Marco Cilia categoria: generale

Quasi sicuramente si, ma più o meno ce lo aspettavamo. Ecco il punto 4 di una articolata risposta di Steve Olechowski (creatore di Feedburner e ora Business Product Manager di AdSense) ad alcune critiche mosse recentemente al servizio dopo la migrazione dei feed degli utenti ai domini di Google:

4. Integration of Feedburner Stats with Google Analytics

Q: When will Google Analytics be integrated with feed statistics, and/or vice versa?

A: We generally don’t announce timelines for product releases. If you’ve already moved to our new Google version of FeedBurner (http://feedburner.google.com), you can see that we are already using the same chart and graph widgets as Google Analytics. We believe more data is better, so working to expand our analytics offering is certainly something that we think is important for AdSense for feeds and FeedBurner.

(generalmente non annunciamo le date di rilascio di prodotti futuri. Se siete già approdati alla nuova versione di Feedburner, avrete visto che stiamo già usando gli stessi grafici e widget grafici di Google analytics. Riteniamo che “più dati è meglio”, quindi lavorare per espandere la nostra offerta di analisi è certamente qualcosa che riteniamo importante per Adsense per feed e Feedburner)

Direi che ricalca abbastanza fedelmente quanto scrissi in questo post, e quindi ci fa ben sperare per il futuro. D’altronde mancano solo poche congiunzioni alla chiusura del cerchio: Feedburner è in Google. Adsense è in Analytics. Adwords è in Analytics. Adsense è nei feed (quindi in Feedburner). Mancano Feedburner in Analytics e la vendita di spazi sui feed tramite Adwords.


Jan 24 2009

HelpSemaforoQuesto semaforo indica il livello difficoltà del post
semaforo verde - articolo per tutti semaforo giallo - articolo avanzato semaforo rosso - articolo per esperti

La web analytics non è tutto!

autore: Marco Cilia categoria: web analytics

Cool Mirror by dprevitePuò sembrare strano detto da me e su questo blog, ma è esattamente quel che penso e l’occasione per ribadirlo mi viene da un caso pratico che ho affrontato qualche giorno fa da un cliente.
Durante l’analisi del traffico degli ultimi tre mesi, e dopo alcune considerazioni sulle fonti, ci imbattiamo in un fenomeno strano: molti URL dei contenuti del sito appaiono duplicati, e funzionanti e visitabili, ancorché non linkati da nessuna parte in apparenza. Alcuni hanno la struttura

/directory/sottodirectory/index/id_contenuto.html

e altri invece

/sottodirectory/index/id_contenuto.html

Il cliente mi avverte che in passato avevano avuto grossi problemi di questo tipo, ma che dopo un lavoro certosino avevano bonificato la situazione, e Google Webmaster Tool lo confermava.
L’analisi dei percorsi di navigazione, delle sorgenti delle visite a questi URL e delle keyword di ingresso portavano tutti a una fonte: Google. A questo punto la web analytics si ferma, ma il cliente ha bisogno di capire. Facendo alcune prove di ricerca e attraverso l’uso degli operatori site: e inurl: riesco a isolare due URL presenti delle pagine dei risultati di Google, ma ancora questo non ci dice nulla. Da dove Google pesca questi indirizzi sbagliati?

L’illuminazione mi è venuta dopo aver notato che gli URL con più visite (quelli esistenti nei link interni al sito) avevano la copia cache, mentre quelli “sbagliati” non avevano la copia cache e recavano la scritta “XX ore fa”. Di che cosa Google non fa la copia cache e conosce bene l’ora di pubblicazione? la prima risposta è “delle news”, perché il sito è presente come fonte in google news, ma anche lì l’operatore site: non fornisce una risposta soddisfacente, il secondo bersaglio sono i feed RSS, e infatti lì vi era l’errore e i link errati.
Ma queste risposte non ce le può dare Google Analytics, nè la web analytics in generale, ed è per questo che dico che la web analytics non è tutto. Sono conscio del fatto che è impossibile essere esperti in mille campi, ma conoscere le basi di funzionamento dei motori di ricerca, l’uso degli operatori e un po’ di SEO non può di certo essere un ostacolo all’attività di WA, anzi.

Avete esperienze simili e altri campi di cui è bene conoscere le basi da suggerire?

image credits: dprevite on flickr


Jan 22 2009

HelpSemaforoQuesto semaforo indica il livello difficoltà del post
semaforo verde - articolo per tutti semaforo giallo - articolo avanzato semaforo rosso - articolo per esperti

Migliorare il tracciamento SEO

autore: Marco Cilia categoria: filtri

Il post precedente ha riscosso un certo interesse nel mondo dei SEO e di chi fa web analytics. Una delle critiche più grandi mosse al metodo riportato è che non è molto chiaro che start=30 non significa pagina 30, ma pagina 2. Per questo motivo Damon Gudaitis ha scritto alcuni altri filtri per sistemare la cosa. Purtroppo il grado di complicazione introdotto non giustifica sempre lo sforzo richiesto, per cui il mio consiglio è di procedere solo se non siete soddisfatti del metodo precedente e se leggendo questo post avrete tutto chiaro.

Il “metodo Damon” estende il tracking anche a Yahoo e MSN. Vi traduco le istruzioni step-by-step, da applicare naturalmente sempre ad un profilo copia:

Filtrare solo il traffico organico:

  1. selezionare la gestione filtri dalla schermata principale
  2. cliccare su aggiungi filtro
  3. assegnare al filtro il nome Traffico Organico
  4. scegliere filtro personalizzato dal menu a tendina e selezionare includi
  5. nel Campo filtro selezionare Mezzo della Campagna
  6. nel Pattern filtro inserire organic
  7. applicare il filtro al profilo-copia desiderato
  8. salvare le modifiche

Restringere il profilo a Google, Yahoo e MSN:

  1. cliccare aggiungi filtro
  2. assegnare al filtro il nome Visitatori da motori di ricerca
  3. scegliere filtro personalizzato dal menu a tendina e selezionare includi
  4. nel campo filtro selezionare Referral
  5. nel Pattern filtro inserire (google|yahoo|msn|live)\.[a-z]+
  6. assegnare il filtro al profilo-copia desiderato
  7. salvare le modifiche

Estrarre le informazioni desiderate dalle SERP di riferimento:

  1. cliccare aggiungi filtro
  2. assegnare al filtro il nome Search Ranking
  3. scegliere filtro personalizzato dal menu a tendina e selezionare avanzato
  4. Campo A -> Estrai A, selezionare Termine Campagna e inserire (.*)
  5. Campo B -> Estrai B, selezionare Referral e inserire (\?|&)(start|first|b)=([^&]*)
  6. Output in -> Constructor, selezionare Definito dall’utente e inserire $A1 | pagina: $B3
  7. applicare il filtro al profilo-copia desiderato
  8. salvare le modifiche

Formattare correttamente la pagina 1:

  1. cliccare aggiungi filtro
  2. assegnare al filtro il nome Pagina 1
  3. scegliere filtro personalizzato dal menu a tendina, poi selezionare Cerca e sostituisci
  4. Campo filtro, selezionare Definito dall’utente. Cerca stringa, scrivere pagina:$
  5. Sostituisci stringa, scrivere pagina: 1
  6. applicare il filtro al profilo-copia desiderato
  7. salvare le modifiche

Formattare correttamente le pagine 2,3, eccetera:
[la ragione per cui le espressioni regolari comprendono 10 e 11, ad esempio, è che Google fa iniziare pagina 2 dal risultato #10, Yahoo e MSN invece dal risultato #11]

  1. per ogni pagina che si vuole tracciare, cliccare aggiungi filtro
  2. assegnare al filtro il nome Pagina 2 (o 3, 4, eccetera…)
  3. scegliere filtro personalizzato dal menu a tendina, poi selezionare Cerca e sostituisci
  4. Campo filtro, scegliere Definito dall’utente
  5. Cerca stringa, inserire pagina: 1[0-1]$ (o pagina: 2[0-1]$ per pagina 3, pagina: 3[0-1]$ per pagina 4 ecetera…)
  6. Sostituisci stringa, inserire pagina 2 (o pagina 3 eccetera…)
  7. applicare il filtro al profilo-copia desiderato
  8. salvare le modifiche

Ordine dei filtri:
Mai come in questo caso l’ordine dei filtri è importante; i filtri che riformattano i numeri di pagina vanno in rigoroso ordine numerico crescente, pena il caos.
L’ordine dei filtri funzionante è questo:

– Traffico Organico
– Visitatori da motori di ricerca
– Search Ranking
– Pagina 1
– Pagina 2
– Pagina 3, eccetera…

La soluzione non mi fa impazzire di gioia, se ricevete visite anche da pagina 12 delle SERP avrete bisogno di 12 filtri per riformattare correttamente i numeri di pagina, ma d’altronde i filtri cerca e sostituisci non sono così versatili da includere una regular expression unica che modifichi tutto. Se proprio sentite l’esigenza di avere i numeri di pagina corretti, questo è quel che dovete fare…


Jan 19 2009

HelpSemaforoQuesto semaforo indica il livello difficoltà del post
semaforo verde - articolo per tutti semaforo giallo - articolo avanzato semaforo rosso - articolo per esperti

La mia guida su html.it e una segnalazione

autore: Marco Cilia categoria: generale

Quando ho iniziato questo blog avevo chiare quattro cose: il titolo e tre progetti che avrei rilasciato, in ordine. Come spesso accade, l’ordine è saltato e la pubblicazione di uno di questi non sta avvenendo su queste pagine, ma sono lo stesso orgoglioso di annunciare che il prestigioso html.it sta pubblicando a puntate una mia guida completa a Google Analytics, in 33 lezioni. Appuntamento ogni venerdì.

La seconda segnalazione è che per tutto il mese di Gennaio tutti gli iscritti di AnalyticsView possono godere gratis del piano Pro

There’s no special procedure necessary to access the Pro Plan. Simply login to your AnalyticsView account and take advantage of all of the Pro Plan features until January 31st.

Sicuramente una occasione da cogliere al volo, visto che il Pro costerebbe 95 dollari al mese. Se non sapete cosa sia AnalyticsView, potete leggere il mio vecchio post a riguardo.